Le problème posé
Classer des pathologies cutanées à partir d'images cliniques revient à demander à un modèle de distinguer des classes qui, à l'œil nu, se ressemblent beaucoup. Deux lésions de nature très différente peuvent partager une forme, une bordure et une teinte proches ; à l'inverse, une même pathologie change d'apparence selon la carnation, l'éclairage et l'appareil qui a pris la photo.
S'ajoute la contrainte qui structure tout le reste : les jeux de données cliniques sont déséquilibrés. Les cas fréquents écrasent numériquement les cas rares, alors que ce sont précisément les cas rares qui comptent. Un modèle qui optimise naïvement l'exactitude globale apprend très vite à ignorer les classes minoritaires - et affiche un score flatteur qui ne dit rien de son utilité réelle.
Pourquoi partir de modèles pré-entraînés
Entraîner un réseau convolutif profond depuis zéro suppose un volume de données annotées que l'imagerie clinique n'offre pas. Le transfer learning contourne l'obstacle : on reprend un réseau déjà entraîné sur un corpus généraliste, on conserve les premières couches - qui ont appris des motifs bas niveau, contours, textures, gradients, valables bien au-delà de leur domaine d'origine - et on ré-apprend les couches hautes sur les images qui nous intéressent.
Le choix qui reste à faire porte sur la profondeur du dégel : figer tout sauf la tête de classification, ou laisser respirer les derniers blocs convolutifs. Plus on dégèle, plus le modèle s'adapte au domaine, et plus il risque de surapprendre un jeu de données restreint. C'est un curseur à régler, pas une case à cocher.
EfficientNet face à ResNet
Les deux architectures répondent à la même question - comment gagner en profondeur sans que l'entraînement se dégrade - par deux réponses différentes. ResNet introduit les connexions résiduelles : chaque bloc apprend un écart par rapport à son entrée plutôt qu'une transformation complète, ce qui laisse le gradient remonter intact à travers des dizaines de couches.
EfficientNet part d'un autre constat : profondeur, largeur et résolution d'entrée ne se règlent pas indépendamment. Son compound scaling les fait croître ensemble selon un rapport fixe, ce qui donne, à budget de paramètres comparable, des modèles nettement plus économes.
La comparaison ne se résume donc pas à « lequel obtient le meilleur score ». À protocole identique - mêmes données, mêmes augmentations, même stratégie de dégel - elle porte sur le comportement : vitesse de convergence, sensibilité aux hyperparamètres, coût d'inférence, et surtout tenue sur les classes minoritaires plutôt que sur la moyenne.
Le prétraitement, là où se joue l'essentiel
La normalisation de la coloration traite une nuisance bien identifiée en imagerie médicale : d'un centre à l'autre, d'un appareil à l'autre, les mêmes tissus ne rendent pas la même chose. Sans correction, le réseau apprend la signature de l'appareil en même temps que la pathologie, et s'effondre dès qu'on lui présente une source qu'il n'a jamais vue.
L'augmentation de données avancée joue sur un autre registre. Rotations, retournements, recadrages, variations de luminosité et de contraste : l'objectif est de fabriquer de la variabilité plausible, celle qu'on rencontrerait vraiment en clinique, sans inventer des images qu'aucun patient ne produirait. Sur les classes rares, l'augmentation fait double emploi - elle régularise et elle rééquilibre.
Le déséquilibre se traite en parallèle, au niveau de l'échantillonnage et de la fonction de coût, pour qu'une erreur sur une classe rare pèse à sa juste mesure plutôt que de se diluer dans la masse.
Ce que donne le modèle publié
Le dépôt publie l'aboutissement de ce travail : un CNN compact - quatre blocs convolutifs suivis de cinq couches denses - entraîné sur HAM10000 et ses sept catégories de lésions, entrées ramenées à 28×28. Sur le découpage d'évaluation, il atteint 0,99 d'exactitude et 0,99 de F1 macro.
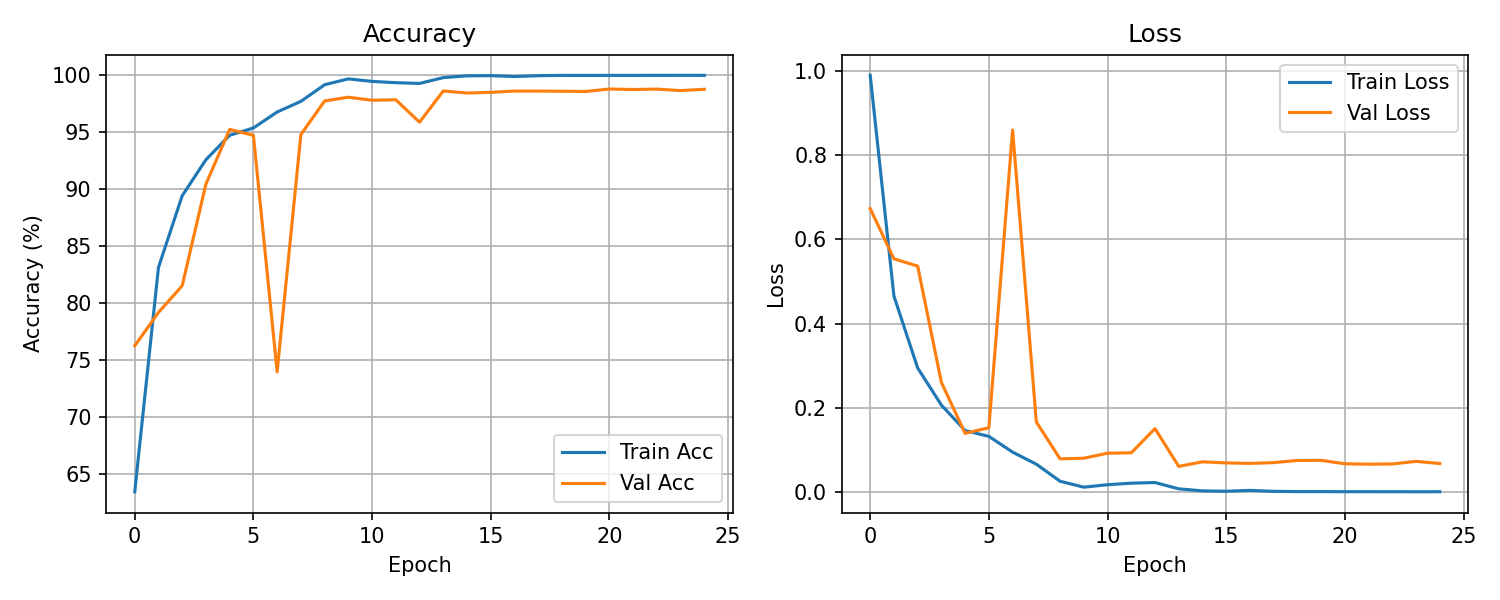
Les courbes d'entraînement racontent mieux l'histoire que le score final. La précision de validation décroche brutalement à la sixième époque - de 95 % à 74 %, avec le pic de perte correspondant - avant de remonter et de se stabiliser autour de 98,7 %. Un creux isolé de cette forme signale un pas d'apprentissage trop agressif sur une fonction de coût accidentée, pas un problème de données. L'écart final entre entraînement et validation, 100 % contre 98,7 %, est le surapprentissage résiduel dont on ne se débarrasse pas complètement sur un jeu de cette taille.
Là où la moyenne ment
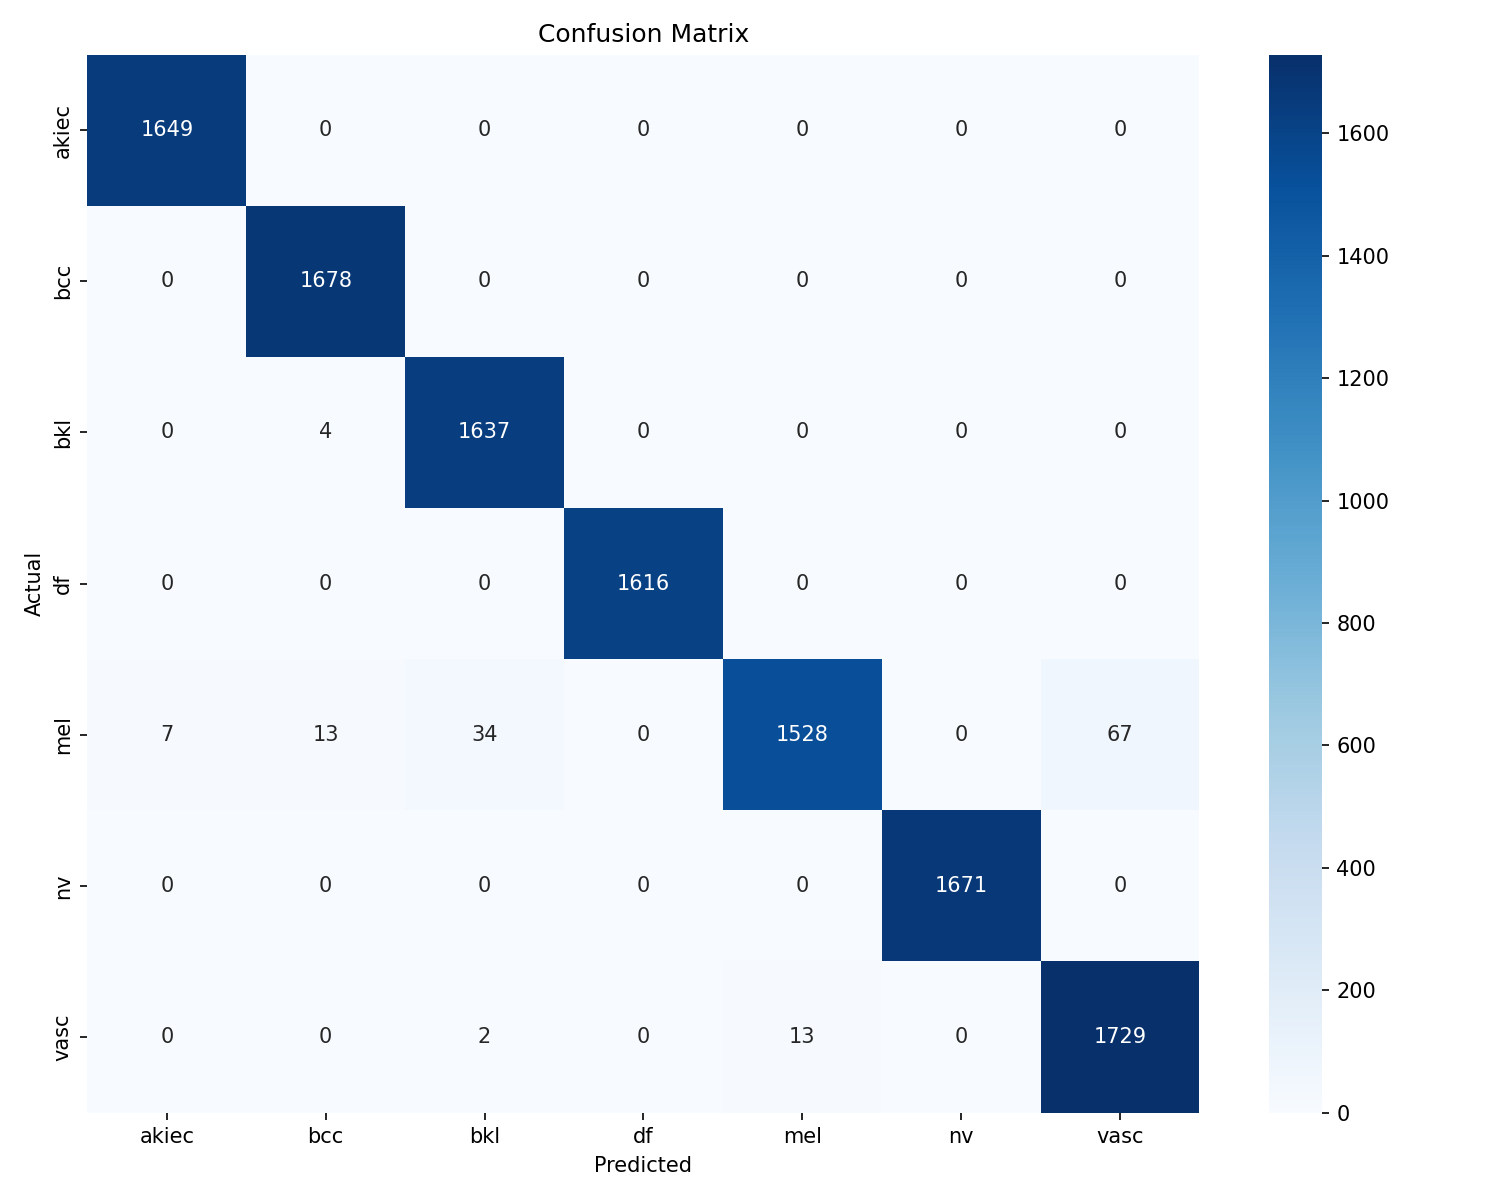
La matrice de confusion confirme le point de méthode. Six classes sur sept sont quasiment parfaites ; le mélanome décroche, à 0,93 de rappel - 67 cas classés en lésions vasculaires, 34 en kératoses bénignes, 13 en carcinomes basocellulaires. C'est exactement la classe sur laquelle une erreur coûte le plus cher, et celle qu'un score global de 0,99 rend invisible.
Un point d'honnêteté pour finir : les sept classes comptent environ 1 650 exemples chacune dans cette matrice, là où HAM10000 est nativement très déséquilibré. Le jeu d'évaluation a donc été rééquilibré, ce qui rend le 0,99 plus flatteur qu'il ne le serait sur la distribution réelle. C'est aussi pour cela que le modèle ne doit pas servir à poser un diagnostic.
Ce que ce travail m'a appris
Le réflexe, sur ce type de problème, est de chercher l'architecture qui gagne. L'expérience mène ailleurs : à jeu de données constant, le pipeline de prétraitement et la manière de traiter le déséquilibre déplacent les résultats davantage que le passage d'une famille de réseaux à l'autre.
L'autre enseignement porte sur les métriques. L'exactitude globale est une mauvaise boussole sur des données déséquilibrées ; il faut regarder les classes une par une, matrice de confusion en main, et accepter qu'un modèle moins bon en moyenne soit le bon choix s'il tient sur ce qui compte.